
在产业机器人这个行当里,川崎重工、发那科、安川电机三家,大概算得上抬头不见低头见的对手。销售冲进同一家车厂、同一家3C工厂抢单,是它们多年来再平常不过的日常。可2026年7月,这三家宣布了一起干一件事,而且联手争夺的既不是产品,也不是零部件,而是数据。
这个项目要给制造现场的具身智能打地基:第一年计划从产线上采集5000小时的作业数据,背后还有日本经产省系统和NEDO最高20亿日元(约合人民币1亿元)的资助。钱不算惊人,事却不太寻常——它透出的方向是,产业机器人的竞争轴心,正在从机器本体的性能,挪向数据的规模与质量。
先把这桩事的事实摆出来:
- 川崎重工、发那科、安川电机联手为制造现场的具身智能构建数据集,项目已入选日本经济产业省与NEDO推动的生成式AI开发支持计划"GENIAC";
- 三家将开发把视觉、触觉、语言、动作一体处理的"VTLA模型"基础,首年从现场采集5000小时的影像、触觉与动作数据;
- 项目周期为2026年8月至2027年7月,NEDO提供最高20亿日元资助,大阪大学、触觉传感器初创FingerVision、AI基础企业ABEJA也参与其中;
- 三家共通化的只是"数据的规格与采集方式",各自的现场数据、控制技术与硬件仍留在自己手里。
对手坐到了一张桌子前
按计划,项目从2026年8月跑到2027年7月,为期一年。具身智能这个词这两年在业内已经不新鲜,指的是在物理世界里动手的AI——不在屏幕上生成文字和图片,而是驱动机器人的手臂和手去抓取、装配、搬运,把活儿真的干完。听起来只是换个输出对象,实际上完全是另一条技术路线。
项目里的分工也很清楚。三家机器人厂商负责把数据的规格和采集平台共通化;大阪大学担任项目主体;受大学委托的ABEJA负责基础技术的提升;触觉传感这块交给初创企业FingerVision。竞争对手、大学、初创企业,为了同一套数据坐到一张桌子前——这个组合本身,就说明了事情的分量。
胜负手从本体挪到了数据
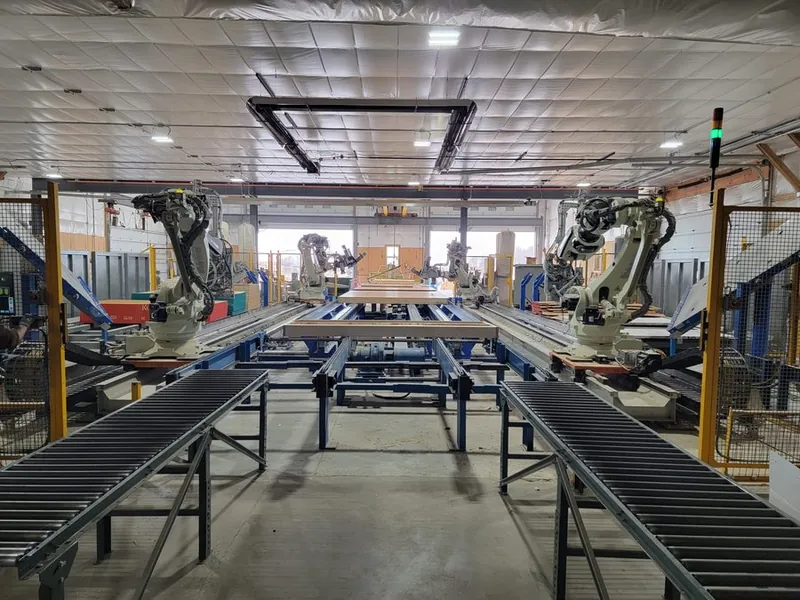
很长时间里,产业机器人的竞争就是硬件的竞争。定位精度、可搬重量、速度、耐久性,一张参数表基本能分出高下。日本厂商几十年攒下的正是这门机械功夫,也靠着它长期站在全球产业机器人厂商的前排。
具身智能考验的是另一种能力。人只要说一句"把那个拿过来",机器人就得自己判断状况、动手完成,哪怕那个零件它从没见过。这种通用动作,光靠精密硬件做不到,得靠海量作业数据喂出来的AI。大语言模型那条经验法则在这里同样管用:训练数据的规模和多样性,很大程度上决定模型的上限。
麻烦在于,这些数据此前在各家手里是割裂的。记录格式、测什么、怎么测,一家一个样,A家采的数据没法直接拿去训B家的模型。格式一旦统一,不同企业、不同工序的数据就能互相用起来,能喂给模型的数据池一下子变大,开发速度也跟着提上来。共通化,就是让这种互相利用成立的那块地基。
再说直白一点:单靠一家,采不齐足够多样的现场数据。你手里就那么几个行业、那么几类工序,把对手的数据用同一套格式汇进来,比各自捂着快得多。对手之所以此刻联手,说到底是因为要争的东西换了。
VTLA想干的事:把"教"换成"学"
开发的核心是一个叫VTLA的模型——Vision、Tactile、Language、Action,视觉、触觉、语言、动作一体处理。它要实现的场景是:听懂人的口头指令,用摄像头看清对象,再凭指尖的触感边调整力度边完成动作,一整套流程由一个模型包圆。
这里面最特别的是触觉。传统产业机器人主要靠视觉和位置信息动作,可夹一个软零件、往略有偏移的孔里插销这类精细手活,感知打滑、拿捏按压的力度是绕不开的。FingerVision的技术,就是来补这块短板的。
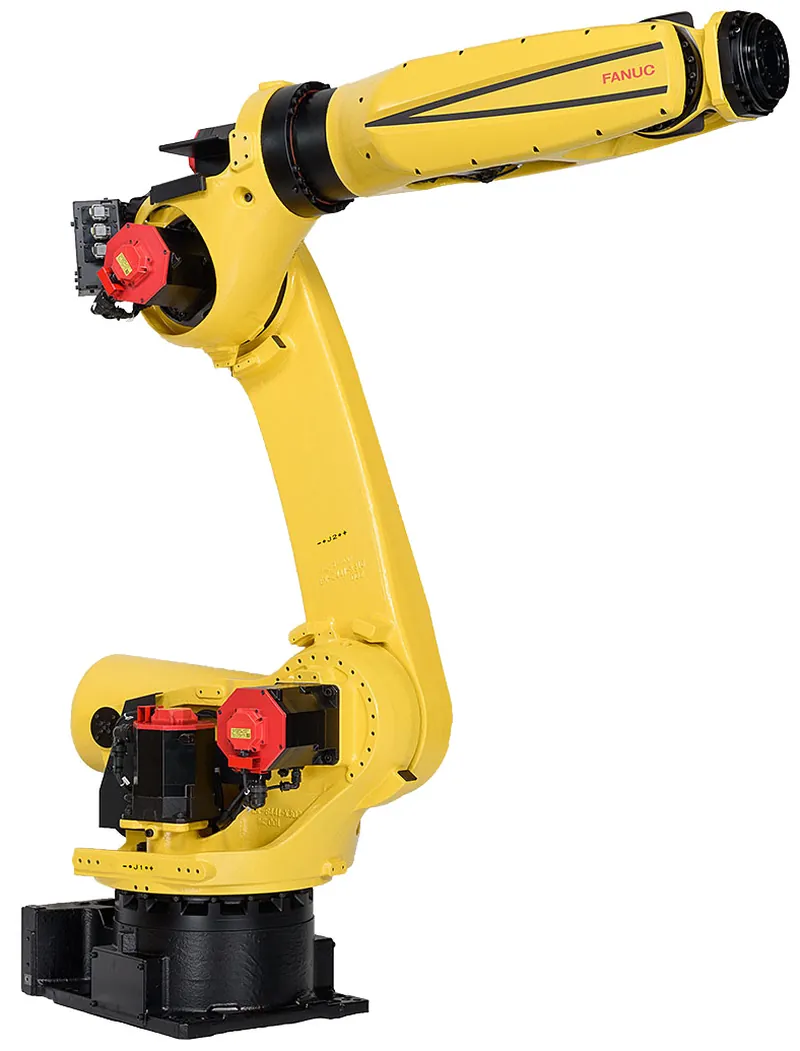
更值得琢磨的是它对示教的替代。现在现场普遍依赖"示教"——把动作一个一个手动教给机器人,每换一个作业对象,工程师就得重新输入一遍坐标和步骤。这道工序是多品种小批量工厂推进自动化绕不过去的墙,也是人手紧张的产线上最耗人的一环。VTLA若能走向实用,机器人学活儿的方式就从"人教"变成"AI自己从数据里学",对第一次碰到的作业也能应付个大概。自动化的前提,可能就此从"教"翻转为"学"。
共享的是规格,争夺的是话语权
三家联手的本质,藏在"哪些共享、哪些不共享"这条边界里。共通化的只有数据的规格与采集方式,也就是怎么记录、怎么存储这套规则。留在各家手里的,是自家工厂的现场数据、机器人的控制技术与硬件,以及最终的产品和服务。底层规则放在一起,较量在其上展开。
这就引出了真正的争点:话语权。用共同格式采来的数据归谁所有、谁能拿去训练、标准细则由谁拍板——握住这些的一方,就在具身智能的基础层占了先手。制定标准,从来同时也是一场对细则决定权的争夺。
把视野放宽一点,这个动作和全球范围的数据争夺是连着的。英伟达正通过研发用的算力平台与仿真环境,扩大自己在具身智能上的立足点;这三家日本厂商另外也在与富士通、英伟达就社会落地展开事业探讨,算力等环节会借海外技术的力。但在"面向现场的数据标准"这件事上,它们想自己握一套日本本土的数据底座——平台可以借一部分,数据的主导权不交出去。这次联手,应当作这个意思来读。
集成商和零部件厂的位置要挪
通用数据集和基础模型一旦成形,影响会溢出机器人厂商之外。
位置挪动最明显的是系统集成商。把机器人装进现场、靠示教让它动起来,一直是集成商的立身之本。当"学"逐渐取代"教",逐条手动示教的活儿会减少,重心转向以数据为轴的服务——帮工厂采到契合现场的数据,把模型调校到贴合某条具体工序。从装设备的人,变成陪数据的人,这个角色改写未必会很慢。
对零部件和传感器厂商则是机会。VTLA把触觉提到这么高的位置,力觉传感器、触觉传感器以及背后支撑它们的精密机械件,需求可能被抬高——这恰好压在日本零部件厂商的强项上。不过价值的落点也可能跟着挪:从"卖一个传感器",变成"这个传感器采的数据如何接进平台"。
还有一点国内同行不妨留意:这套数据标准会不会顺着亚洲制造业供应链往外延伸,是未来一两年值得持续盯着看的变量。
接下来盯什么:三个问号
数据的使用权。共通化之后数据归谁、各家能用到什么范围、标准内容的决定权在三家之间怎么分——这些若始终含糊,共通化的口号可以一直喊下去,却未必能长成真正的标准。项目后续公布的运营规则,是第一份判断依据。
数据的量。首年5000小时够不够训练一个通用模型,从外面很难评估。对照大语言模型吞下的文本量级,5000小时更像一个起点;不过现场作业数据每小时的信息含量很高,也不能拿时长硬比。真正决定模型成色的,是从第二年起还能追加多少。
日本标准能不能走出去。靠硬件称雄全球的日本厂商,能否在"数据"这个新战场握住主导权?这个为期一年的项目,是最早的那块试金石。
对我们这类天天跟这三家设备打交道的服务商来说,这事还有一层现实的意味:往后产线上机器的"口音"可能会变。过去二十年,维修调试工程师的核心手艺是示教、参数、故障排查;接下来,懂现场数据、会陪AI"喂数"的工程师,身价只会更高。机器还是那些机器,玩法正在换轨。相关服务:进口品牌维修保养、品牌覆盖与机型资料。



















