
در صنعت رباتهای صنعتی، این سه شرکت—صنایع سنگین کاواساکی، FANUC و یاسکاوا—را میتوان رقیبهایی دانست که مدام به هم برمیخورند. سالهاست تیمهای فروششان برای ربودن سفارش به یک کارخانه خودروسازی و یک کارخانه 3C یکسان یورش میبرند و این عادیترین کار روزمرهشان بوده است. اما در ژوئیه 2026، این سه شرکت اعلام کردند که قرار است با هم کاری را پیش ببرند، و چیزی که بر سرش دست به اتحاد زدهاند نه محصول است و نه قطعه—داده است.
این پروژه قرار است پیریزی هوش مصنوعی مجسم (Embodied AI) در محیط تولید را انجام دهد: در سال نخست قرار است 5000 ساعت داده عملیاتی از خطوط تولید گردآوری شود و در پشت آن نیز حمایت چارچوب وزارت اقتصاد، تجارت و صنعت ژاپن و کمکهزینه حداکثر 2 میلیارد یِنی NEDO (معادل حدود 100 میلیون یوان) قرار دارد. مبلغ چشمگیر نیست، اما ماجرا هم معمولی نیست—جهتی که از آن برمیآید چنین است: محور رقابت رباتهای صنعتی دارد از عملکرد بدنه ماشین به سمت مقیاس و کیفیت داده جابهجا میشود.
ابتدا واقعیتهای این ماجرا را روی میز بگذاریم:
- صنایع سنگین کاواساکی، FANUC و یاسکاوا برای ساخت مجموعهداده هوش مصنوعی مجسم در محیط تولید دست به هم دادهاند؛ پروژه در برنامه حمایت از توسعه هوش مصنوعی مولد «GENIAC» که وزارت اقتصاد، تجارت و صنعت ژاپن و NEDO پیش میبرند پذیرفته شده است؛
- سه شرکت پایه «مدل VTLA» را توسعه میدهند که بینایی، لامسه، زبان و حرکت را بهصورت یکپارچه پردازش میکند و در سال نخست، 5000 ساعت داده تصویری، لمسی و حرکتی از محیط کار گردآوری خواهد شد؛
- بازه پروژه از اوت 2026 تا ژوئیه 2027 است و NEDO تا سقف 2 میلیارد ین کمکهزینه میدهد؛ دانشگاه اوساکا، استارتاپ حسگرهای لمسی FingerVision و شرکت زیرساخت هوش مصنوعی ABEJA نیز در آن حضور دارند؛
- چیزی که این سه شرکت با هم همسان میکنند تنها «مشخصات داده و روش گردآوری آن» است؛ داده میدانی، فناوری کنترل و سختافزار هر شرکت همچنان دست خودش میماند.
رقیبها به یک میز نشستند
طبق برنامه، پروژه از اوت 2026 تا ژوئیه 2027 و به مدت یک سال اجرا میشود. اصطلاح هوش مصنوعی مجسم در این دو سال اخیر برای اهالی صنعت دیگر تازه نیست و به هوشی اشاره دارد که در دنیای فیزیکی دست به کار میشود—نه اینکه روی صفحه نمایش، متن و تصویر تولید کند، بلکه بازو و دست ربات را برای گرفتن، مونتاژ و جابهجایی به حرکت درآورد و کار را واقعاً تا انتها پیش ببرد. به نظر میرسد فقط مقصد خروجی عوض شده، اما در عمل این کاملاً مسیر فناورانه دیگری است.
تقسیم کار پروژه هم روشن است. سه رباتساز مسئول همسانسازی مشخصات داده و بستر گردآوری آن هستند؛ دانشگاه اوساکا نهاد اصلی پروژه است؛ ABEJA که از سوی دانشگاه مأمور شده، مسئول ارتقای فناوریهای پایه است؛ و بخش حسگرهای لمسی به استارتاپ FingerVision سپرده شده است. رقیب، دانشگاه و استارتاپ که برای یک مجموعه داده به یک میز مینشینند—خودِ این ترکیب، از سنگینی ماجراست حکایت میکند.
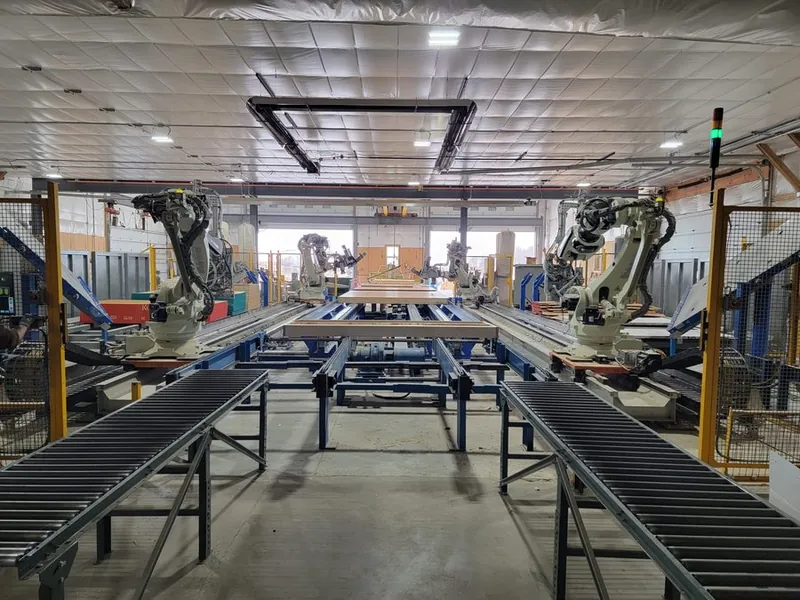
کارت تعیینکننده از بدنه به داده منتقل شد
برای مدت طولانی، رقابت رباتهای صنعتی یعنی رقابت سختافزار. دقت موقعیتیابی، ظرفیت بار، سرعت، دوام—یک جدول مشخصات فنی تقریباً برتری را معلوم میکرد. آنچه سازندگان ژاپنی طی چند دهه اندوختهاند درست همین مهارت مکانیکی است و به پشتوانه همان، مدتها در ردیف نخست رباتسازان صنعتی جهان جای گرفتهاند.
هوش مصنوعی مجسم توان متفاوتی را محک میزند. انسان فقط بگوید «آن را بردار بیاور»، ربات باید خودش وضعیت را بسنجد و کار را تمام کند، حتی اگر آن قطعه را هرگز ندیده باشد. چنین حرکت همهمنظورهای با سختافزار دقیق بهتنهایی ممکن نیست و به هوشی نیاز دارد که با انبوهی از داده عملیاتی تغذیه شده باشد. همان قاعده تجربی مدلهای زبانی بزرگ اینجا هم برقرار است: مقیاس و تنوع داده آموزشی، تا حد زیادی سقف مدل را رقم میزند.
دشواری اینجاست که این دادهها تا پیش از این نزد هر شرکت جزیرهای و پراکنده بودند. قالب ثبت، اینکه چه چیزی سنجیده شود و چگونه—هر شرکت رویه خودش را داشت و دادهای که شرکت A جمع کرده بود، مستقیم قابل استفاده برای آموزش مدل شرکت B نبود. به محض یکدست شدن قالب، داده شرکتها و فرایندهای مختلف قابل استفاده متقابل میشوند، استخر دادهای که میتوان به مدل خوراند یکباره بزرگتر میشود و سرعت توسعه هم بالا میرود. همسانسازی، همان زیربنایی است که این استفاده متقابل را ممکن میکند.
اگر کمی رکتر بگوییم: هیچ شرکتی بهتنهایی نمیتواند داده میدانی بهاندازه کافی متنوع گردآوری کند. آنچه در دست دارید همین چند صنعت و همین چند نوع فرایند است؛ آوردن داده رقیبها با قالبی واحد بسیار سریعتر از آن است که هر کدام دادههایش را برای خودش نگه دارد. اینکه رقیبها دقیقاً در همین لحظه اتحاد بستهاند، در نهایت به این دلیل است که موضوعِ رقابت عوض شده است.
کاری که VTLA میخواهد بکند: جایگزینی «آموزش» با «یادگیری»
هسته توسعه، مدلی به نام VTLA است—Vision، Tactile، Language، Action؛ یعنی پردازش یکپارچه بینایی، لامسه، زبان و حرکت. سناریویی که باید محقق شود چنین است: فرمان شفاهی انسان را بفهمد، شیء را با دوربین بهروشنی ببیند و سپس با حس لمسی نوک انگشتان، همزمان با تنظیم نیرو، حرکت را کامل کند—کل این فرایند را یک مدل از ابتدا تا انتها به دوش میکشد.
خاصترین بخش اینجا لامسه است. رباتهای صنعتی سنتی عمدتاً با اتکا به بینایی و اطلاعات موقعیت حرکت میکنند، اما در کارهای ظریف دست مانند گرفتن یک قطعه نرم یا فرو کردن پین در حفرهای با انحراف جزئی، حس لغزش و تنظیم نیروی فشار اجتنابناپذیر است. فناوری FingerVision دقیقاً برای پر کردن همین نقطه ضعف به میدان آمده است.
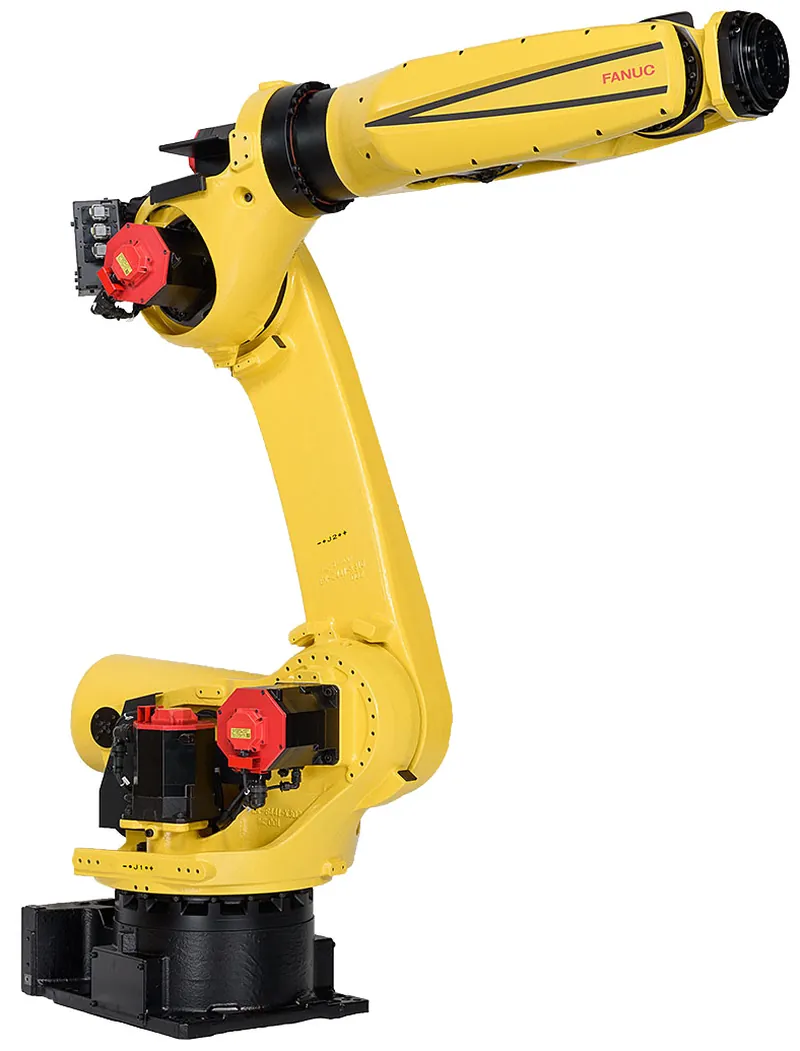
نکته تأملبرانگیزتر، جایگزینی تچینگ است. امروزه محیط تولید عمدتاً به «تچینگ» وابسته است—حرکات تکتک بهصورت دستی به ربات آموخته میشوند و با هر تغییر شیء کار، مهندس باید مختصات و مراحل را از نو وارد کند. این فرایند، دیواری گریزناپذیر در مسیر خودکارسازی کارخانههای با تنوع محصول بالا و تیراژ کم است و در خطوطی که با کمبود نیرو دستبهگریباناند، پرمصرفترین حلقه به شمار میرود. اگر VTLA به مرحله کاربردی برسد، روش یادگیری کار از سوی ربات از «آموزش توسط انسان» به «یادگیری خودِ هوش مصنوعی از دل دادهها» تبدیل میشود و حتی در نخستین برخورد با کاری تازه هم تا حدی از عهده برمیآید. ممکن است پیشفرض خودکارسازی همینجا از «آموزش» به «یادگیری» برگردد.
مشترک میشود مشخصات، رقابت میشود بر سر حق حرف آخر
جوهره اتحاد این سه شرکت در مرز «چه چیزی مشترک شود و چه چیزی نه» نهفته است. تنها مشخصات داده و روش گردآوری آن همسان میشود؛ یعنی قواعدِ چگونگی ثبت و ذخیره. آنچه نزد هر شرکت میماند، داده میدانی کارخانه خودش، فناوری کنترل و سختافزار ربات و در نهایت محصول و خدماتش است. قواعد لایه پایین روی میز مشترک میآید و رقابت روی آن آغاز میشود.
اینجا نقطه واقعی نزاع پدیدار میشود: حق حرف آخر. داده گردآوریشده با قالب مشترک به چه کسی تعلق دارد، چه کسی اجازه دارد با آن آموزش ببیند و جزئیات استاندارد را چه کسی نهایی میکند—طرفی که اینها را در اختیار بگیرد، در لایه زیربنایی هوش مصنوعی مجسم پیشدستی کرده است. استانداردگذاری از دیرباز همیشه و همزمان نبردی بر سر حق تصمیم درباره جزئیات نیز بوده است.
اگر زاویه دید را کمی باز کنیم، این حرکت به رقابت جهانی بر سر دادهها پیوند خورده است. انویدیا (NVIDIA) با بسترهای محاسباتی پژوهشی و محیطهای شبیهسازی، پایگاه خود در هوش مصنوعی مجسم را میگستراند؛ این سه شرکت ژاپنی جدا از این، درباره بهکارگیری اجتماعی با فوجیتسو و انویدیا نیز در حال بررسی کسبوکارند و در حلقههایی مانند توان محاسباتی از فناوری خارجی بهره خواهند گرفت. اما در موضوع «استاندارد داده متمرکز بر محیط تولید»، میخواهند یک زیرساخت داده بومی ژاپن را خودشان در دست بگیرند—بخشی از بستر را میتوان قرض گرفت، اما رهبری داده از دست خارج نمیشود. این اتحاد را باید با همین معنا خواند.
جای سیستماینتگریتورها و قطعهسازها جابهجا میشود
به محض شکل گرفتن مجموعهدادههای همهمنظوره و مدلهای پایه، اثرشان از مرز شرکتهای رباتساز فراتر خواهد رفت.
بیانگر این جابهجایی، سیستماینتگریتورها هستند. نصب ربات در محل و به راه انداختنش با تچینگ، همیشه تکیهگاه کسبوکار اینتگریتور بوده است. وقتی «یادگیری» بهتدریج جای «آموزش» را بگیرد، کارِ تچینگ دستی موردبهمورد کم میشود و ثقل امور به خدمات محور داده منتقل میگردد—کمک به کارخانه برای گردآوری داده سازگار با محیط خودش و تنظیم مدل تا با یک فرایند مشخص بخورد. از فردِ نصبکننده تجهیزات، به همراهِ دادهها تبدیل شدن—بازنویسی این نقش لزوماً کُند پیش نمیرود.
برای تولیدکنندگان قطعات و حسگرها اما فرصت است. VTLA لامسه را به چنین جایگاه بلندی برده است؛ تقاضا برای حسگرهای نیرو و لامسه و قطعات مکانیکی دقیق پشتیبانشان احتمالاً بالا میرود—دقیقاً منطبق بر نقطه قوت قطعهسازهای ژاپنی. البته نقطه فرود ارزش هم ممکن است همراهش جابهجا شود: از «فروش یک حسگر» به «اینکه داده ثبتشده با این حسگر چگونه به بستر وصل میشود».
نکتهای نیز که همکاران ما در بازار داخلی چین بهتر است از چشمشان دور نماند: اینکه این استاندارد داده همراه زنجیره تأمین صنعت ساخت آسیا به بیرون تسری پیدا میکند یا نه، متغیری است که در یکی دو سال آینده ارزش دنبالکردن مداوم دارد.
از این پس چه چیزی را زیر نظر بگیریم: سه علامت سؤال
حق استفاده از داده. پس از همسانسازی، دادهها به چه کسی تعلق دارند، هر شرکت تا چه محدودهای میتواند از آنها بهره ببرد و حق تصمیم درباره محتوای استاندارد میان سه شرکت چگونه تقسیم میشود—تا وقتی اینها مبهم بماند، میتوان شعار همسانسازی را مدام سر داد، اما لزوماً به استاندارد واقعی تبدیل نمیشود. قواعد بهرهبرداری که پروژه بعداً اعلام میکند، نخستین ملاک داوری است.
حجم داده. اینکه آیا 5000 ساعت در سال نخست برای آموزش یک مدل همهمنظوره کافی است، از بیرون بهسختی قابل ارزیابی است. در مقایسه با حجم متنی که مدلهای زبانی بزرگ فرو میبرند، 5000 ساعت بیشتر شبیه یک نقطه شروع است؛ البته داده عملیاتی محیط تولید به ازای هر ساعت محتوای اطلاعاتی بسیار بالایی دارد و نمیتوان صرفاً بر پایه ساعت مقایسه کرد. آنچه واقعاً کیفیت مدل را تعیین میکند، این است که از سال دوم به بعد چه مقدار به آن افزوده شود.
استاندارد ژاپنی میتواند راه بیرون مرزها باز شود یا نه. آیا سازندگان ژاپنی که با سختافزار بر جهان چیره شدهاند، میتوانند در میدان نوبتی به نام «داده» هم رهبری را در دست بگیرند؟ این پروژه یکساله، نخستین سنگ محک است.
برای خدماتی مثل ما که هر روز با تجهیزات این سه برند سروکار داریم، این ماجرا معنایی عملی هم دارد: از این پس ممکن است «لهجه» ماشینهای خط تولید عوض شود. طی بیست سال گذشته، حرفه اصلی مهندسان تعمیر و راهاندازی، تچینگ، پارامترها و عیبیابی بود؛ از این به بعد، مهندسانی که داده میدانی را میفهمند و بلدند به هوش مصنوعی «غذا بدهند»، فقط باارزشتر میشوند. ماشینها همان ماشینها هستند، اما شیوه بازی دارد ریل عوض میکند. خدمات مرتبط: تعمیر و نگهداری برندهای وارداتی، پوشش برندها و مستندات مدلها.
مطالب مرتبط
- مرجع سریع کدهای هشدار FANUC
- فروش رباتهای کارکرده
- پایه نصبشده برندهای داخلی چین و اکوسیستم نگهداری و تعمیر



















