
Di dunia robot industri, Kawasaki Heavy Industries, FANUC, dan Yaskawa Electric adalah tiga pesaing yang nyaris mustahil saling menghindari. Tim penjualan mereka berkecamuk di pabrik otomotif dan pabrik elektronik 3C yang sama demi merebut order—sudah puluhan tahun itulah keseharian mereka. Namun pada Juli 2026, ketiganya mengumumkan mengerjakan satu hal bersama, dan yang diperebutkan lewat kerja sama ini bukan produk, bukan pula komponen, melainkan data.
Proyek ini dimaksudkan membangun fondasi bagi kecerdasan tertanam di lantai produksi: pada tahun pertama direncanakan pengumpulan 5.000 jam data operasi dari lini produksi, dengan dukungan kerangka Kementerian Ekonomi, Perdagangan dan Industri Jepang serta dana hingga 2 miliar yen dari NEDO (sekitar 100 juta CNY). Uangnya tidak tergolong fantastis, tetapi peristiwanya tidak biasa—aroma yang tercium adalah poros persaingan robot industri sedang bergeser dari performa badan mesin menuju skala dan kualitas data.
Mari kita bariskan dulu fakta-faktanya:
- Kawasaki Heavy Industries, FANUC, dan Yaskawa Electric berkolaborasi membangun dataset bagi kecerdasan tertanam di lantai produksi; proyek ini telah lolos seleksi program dukungan pengembangan AI generatif "GENIAC" yang didorong Kementerian Ekonomi, Perdagangan dan Industri Jepang bersama NEDO;
- Ketiganya akan mengembangkan fondasi "model VTLA" yang mengolah penglihatan, perabaan, bahasa, dan gerakan secara terpadu, dengan mengumpulkan 5.000 jam data citra, taktil, dan gerakan dari lapangan pada tahun pertama;
- Periode proyek berlangsung Agustus 2026 hingga Juli 2027 dengan pendanaan NEDO hingga 2 miliar yen; Universitas Osaka, startup sensor taktil FingerVision, dan perusahaan infrastruktur AI ABEJA juga ikut terlibat;
- Yang diseragamkan bersama hanyalah "spesifikasi dan metode pengumpulan data"; data lapangan, teknologi kontrol, dan perangkat keras masing-masing tetap dipegang sendiri.
Para Pesaing Duduk di Satu Meja
Sesuai rencana, proyek berjalan dari Agustus 2026 sampai Juli 2027, tepat satu tahun. Istilah kecerdasan tertanam dua tahun belakangan sudah tidak asing di industri: AI yang bekerja di dunia fisik—bukan menghasilkan teks dan gambar di layar, melainkan menggerakkan lengan dan tangan robot untuk mengambil, merakit, memindahkan, hingga benar-benar menuntaskan pekerjaan. Terdengar seperti sekadar mengganti media keluaran; sesungguhnya ini jalur teknologi yang sama sekali berbeda.
Pembagian peran dalam proyek juga gamblang. Ketiga produsen robot bertugas menyeragamkan spesifikasi data dan platform pengumpulan; Universitas Osaka menjadi pelaksana utama proyek; ABEJA yang ditunjuk oleh universitas menangani peningkatan teknologi dasar; sementara urusan sensor taktil diserahkan kepada startup FingerVision. Pesaing, universitas, dan perusahaan rintisan duduk di satu meja demi satu set data yang sama—susunan semacam ini saja sudah cukup menunjukkan bobot persoalannya.
Penentu Menang-Kalah Bergeser dari Badan Mesin ke Data
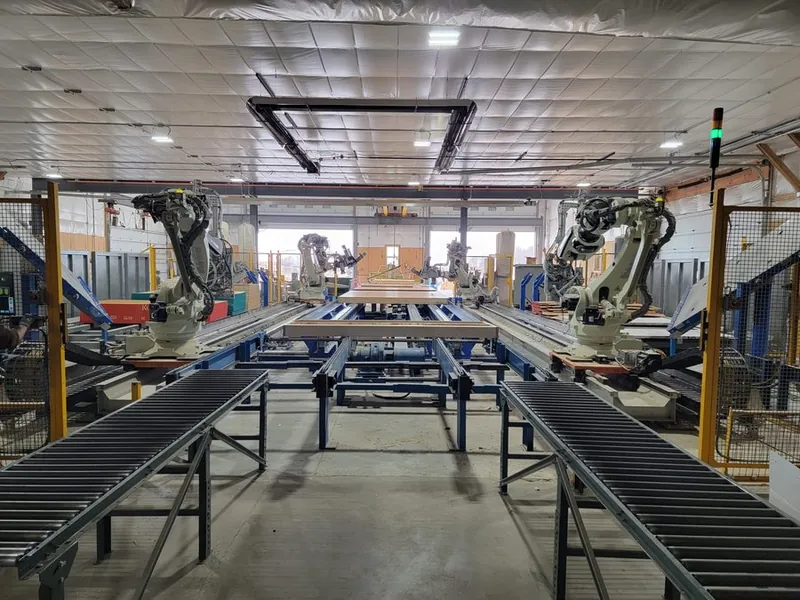
Dalam waktu panjang, persaingan robot industri identik dengan persaingan perangkat keras. Akurasi posisi, kapasitas angkut, kecepatan, ketahanan—satu lembar tabel spesifikasi praktis cukup menentukan unggul atau tidaknya. Kecakapan mekanis yang ditimbun produsen Jepang selama puluhan tahun persis di bidang inilah, dan berkat itulah mereka lama berdiri di barisan depan produsen robot industri dunia.
Kecerdasan tertanam menguji kemampuan jenis lain. Cukup manusia berkata "ambilkan itu", robot harus menilai sendiri keadaannya dan menuntaskan tindakan, sekalipun komponen itu belum pernah dilihatnya. Gerakan generik seperti ini tidak mungkin diwujudkan oleh perangkat keras presisi semata; dibutuhkan AI yang "diberi makan" data operasi dalam jumlah masif. Aturan praktis dari model bahasa besar tetap berlaku di sini: skala dan keragaman data pelatihan sangat menentukan langit-langit model.
Persoalannya, selama ini data terpecah-pecah di tangan masing-masing pihak. Format pencatatan, apa yang diukur, bagaimana cara mengukurnya—setiap perusahaan punya caranya sendiri; data yang dikumpulkan pihak A tidak bisa langsung dipakai melatih model pihak B. Begitu format diseragamkan, data dari perusahaan dan proses produksi yang berbeda dapat saling dipakai, kolam data yang dapat diberikan kepada model serta-merta membesar, dan kecepatan pengembangan ikut menanjak. Standardisasi itulah fondasi yang membuat saling-pakai ini mungkin.
Kalau mau diucapkan lebih lugas: seorang diri, tidak ada satu perusahaan pun sanggup menghimpun data lapangan yang cukup beragam. Yang ada di tangan hanya beberapa industri dan beberapa jenis proses; mengalirkan data para pesaing ke dalam satu format yang sama jauh lebih cepat daripada masing-masing mengurungnya rapat-rapat. Para pesaing justru berjanji di momen ini, jelas karena benda yang diperebutkan sudah berganti.
Misi VTLA: Mengganti "Mengajar" dengan "Belajar"
Inti pengembangannya adalah model bernama VTLA—Vision, Tactile, Language, Action—yang mengolah penglihatan, perabaan, bahasa, dan gerakan secara terpadu. Skenario yang hendak diwujudkan: memahami perintah lisan manusia, memeriksa objek dengan jelas lewat kamera, lalu bersandar pada sensasi raba di ujung jari sambil menyetel daya dan menuntaskan gerakan—satu rangkaian proses dijejalkan penuh ke satu model.
Yang paling istimewa di antara semuanya adalah perabaan. Robot industri tradisional bergerak terutama dengan penglihatan dan informasi posisi, padahal untuk pekerjaan tangan yang halus—memegang komponen lunak, menancapkan pin ke lubang yang sedikit bergeser—kemampuan merasakan selip dan menakar daya tekan tidak bisa dielakkan. Teknologi FingerVision hadir justru untuk menambal kekurangan itu.
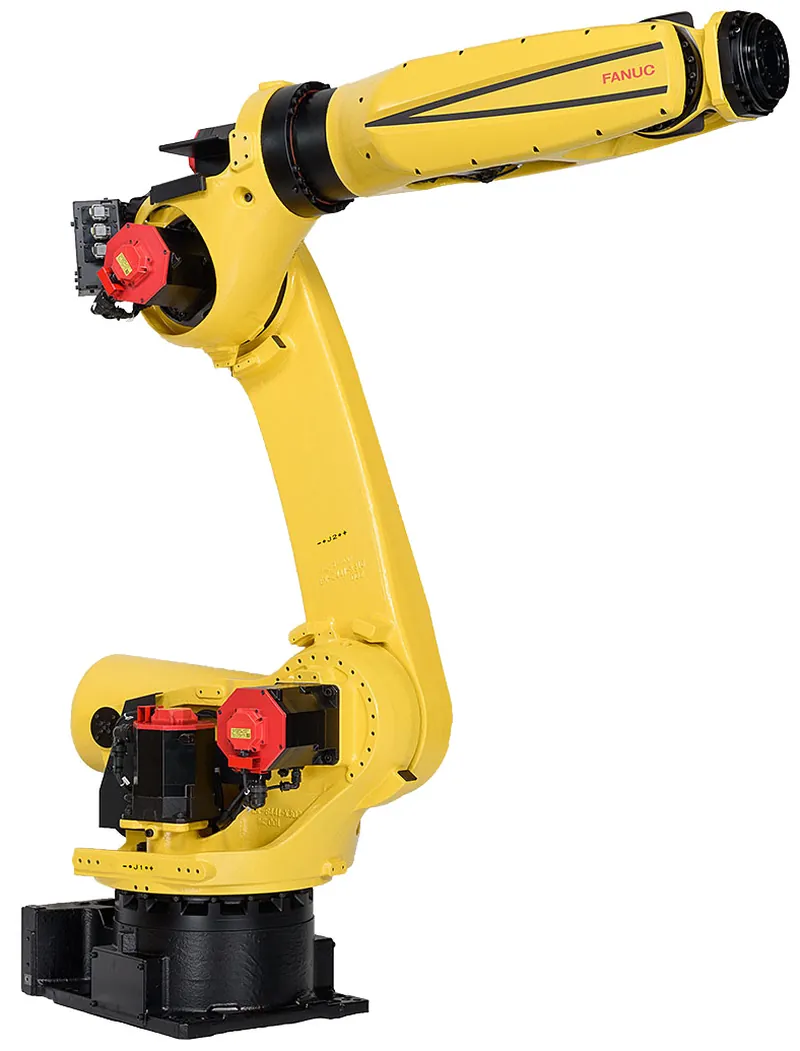
Yang lebih layak direnungkan adalah penggantiannya terhadap teach-in. Lapangan saat ini sangat bergantung pada "teach-in"—gerakan diajarkan satu per satu secara manual kepada robot; setiap kali objek kerja berganti, insinyur harus memasukkan ulang koordinat dan langkah-langkahnya. Tahap ini adalah dinding yang tak terbendung bagi pabrik berbagai-varian-volume-kecil yang tengah memajukan otomasi, sekaligus bagian paling menyita manusia di lini produksi yang kekurangan tangan. Jika VTLA sampai praktis, cara robot mempelajari pekerjaan berubah dari "diajari manusia" menjadi "AI belajar sendiri dari data", dan pekerjaan yang pertama kali ditemuinya pun kira-kira bisa dihadapi. Prasyarat otomasi bisa jadi berbalik dari "mengajar" menjadi "belajar".
Spesifikasi Dibagi Bersama, Kendali Aturan Diperebutkan
Hakikat kolaborasi ketiganya tersembunyi di dalam garis batas "apa yang dibagikan, apa yang tidak". Yang diseragamkan hanya spesifikasi data dan metode pengumpulan—yakni aturan tentang cara mencatat dan menyimpan. Yang tinggal di tangan masing-masing adalah data lapangan pabrik sendiri, teknologi kontrol dan perangkat keras robot, serta produk dan layanan akhir. Aturan lapisan dasar diletakkan di tengah bersama; pertarungannya berlangsung di atasnya.
Dari situ muncul titik perebutan yang sebenarnya: hak bicara. Data yang dikumpulkan dengan format bersama menjadi milik siapa, siapa yang boleh memakainya untuk pelatihan, siapa yang memutuskan rincian standar—pihak yang menggenggam hal-hal ini lebih dulu menempati posisi untung di lapisan fondasi kecerdasan tertanam. Penyusunan standar, sejak dulu, selalu sekaligus merupakan perebutan hak menentukan rinciannya.
Dengan memperlebar sudut pandang, langkah ini terhubung dengan perebutan data berdimensi global. NVIDIA sedang memperluas pijakannya di kecerdasan tertanam melalui platform komputasi riset dan lingkungan simulasi; ketiga produsen Jepang ini di lain pihak juga sedang menjajaki kerja sama bisnis dengan Fujitsu dan NVIDIA terkait penerapan di masyarakat, dan pada mata rantai seperti komputasi akan meminjam tenaga teknologi luar negeri. Namun dalam soal "standar data yang menghadap lapangan", mereka ingin menggenggam sendiri satu landasan data domestik Jepang—platform boleh dipinjam sebagian, kendali atas data tidak diserahkan. Kolaborasi kali ini selayaknya dibaca dengan makna itu.
Posisi Integrator dan Pabrik Komponen Akan Bergeser
Begitu dataset generik dan model fondasi terbentuk, pengaruhnya akan meluber keluar lingkaran produsen robot.
Pergeseran paling mencolok dialami integrator sistem. Memasang robot di lapangan lalu menghidupkannya dengan teach-in selama ini adalah hidup-hidupnya integrator. Ketika "belajar" pelan-pelan menggantikan "mengajar", pekerjaan teach-in manual satu per satu akan menyusut, dan titik berat beralih ke layanan berporos pada data—membantu pabrik memperoleh data yang pas dengan lapangannya, menyetel model hingga menempel pada satu proses produksi tertentu. Dari orang yang memasang peralatan menjadi orang yang menemani data: penulisan ulang peran ini belum tentu berjalan lambat.
Bagi produsen komponen dan sensor, ini justru peluang. VTLA mengangkat perabaan setinggi itu; permintaan sensor gaya, sensor taktil, serta komponen mekanis presisi yang menopangnya berpotensi terangkat—persis menindih wilayah keunggulan produsen komponen Jepang. Hanya saja titik jatuh nilai bisa ikut berpindah: dari "menjual sebuah sensor" menjadi "bagaimana data yang direkam sensor itu tersambung ke platform".
Ada satu hal lagi yang patut dicermati para sejawat di Tiongkok: apakah standar data ini akan menjalar keluar mengikuti rantai pasok manufaktur Asia—itu variabel yang layak terus diawasi sepanjang satu-dua tahun ke depan.
Yang Diawasi Selanjutnya: Tiga Tanda Tanya
Hak pakai data. Setelah diseragamkan, data menjadi milik siapa, sampai cakupan mana tiap pihak boleh memakainya, bagaimana hak menentukan isi standar dibagi di antara ketiganya—selama hal-hal ini terus mengambang, seruan standardisasi bisa terus dikumandangkan tanpa tentu tumbuh menjadi standar sungguhan. Aturan operasional yang dipublikasikan proyek ini selanjutnya adalah bahan penilaian pertama.
Jumlah data. Cukup atau tidaknya 5.000 jam pada tahun pertama untuk melatih satu model generik sulit dinilai dari luar. Dibandingkan volume teks yang ditelan model bahasa besar, 5.000 jam lebih mirip titik awal; namun data operasi lapangan padat informasi per jamnya, sehingga tidak adil bila dipaksa dibandingkan semata lewat durasi. Yang benar-benar menentukan mutu model adalah seberapa banyak data masih bisa ditambahkan sejak tahun kedua.
Bisakah standar Jepang melangkah keluar. Produsen Jepang yang bertakhta di dunia lewat perangkat keras—mampukah mereka menggenggam kendali di medan tempur baru bernama "data"? Proyek satu tahun inilah batu uji yang paling awal.
Bagi penyedia jasa seperti kami yang setiap hari bergaul dengan perangkat ketiga merek ini, peristiwa itu membawa satu lapis makna praktis: "aksen" mesin-mesin di lini produksi ke depan mungkin berubah. Dua puluh tahun silam, keahlian inti insinyur perbaikan dan penyetelan adalah teach-in, parameter, dan penelusuran gangguan; ke depan, nilai insinyur yang memahami data lapangan dan piawai "memberi makan" AI hanya akan semakin tinggi. Mesinnya masih mesin yang itu-itu, tetapi cara memainkannya sedang berpindah jalur. Layanan terkait: perawatan dan perbaikan merek impor, cakupan merek dan dokumentasi model.
Bacaan lanjutan
- Rujukan cepat kode alarm FANUC
- Penjualan robot bekas
- Jumlah terpasang merek Tiongkok dan ekosistem perawatannya



















