
In der Welt der Industrieroboter sind Kawasaki Heavy Industries, FANUC und Yaskawa Electric drei Rivalen, die einander ständig über den Weg laufen. Dass ihre Vertriebe bei denselben Automobilherstellern und denselben 3C-Fabriken um Aufträge wetteifern, gehört seit Jahren zum ganz gewöhnlichen Alltag. Doch im Juli 2026 kündigten die drei an, eine Sache gemeinsam anzupacken – und was sie dabei erobern wollen, ist weder ein Produkt noch ein Bauteil, sondern Daten.
Dieses Projekt legt das Fundament für Embodied AI in der Fertigung: Im ersten Jahr sollen 5.000 Stunden Prozessdaten von den Produktionslinien erhoben werden; im Rücken stehen Fördermittel aus dem METI-System und von der NEDO in Höhe von bis zu 2 Mrd. JPY (rund 100 Mio. CNY). Die Summe ist nicht sonderlich spektakulär, die Sache hingegen schon – denn sie verrät die Richtung: Die Wettbewerbsachse der Industrieroboter verschiebt sich von der Leistungsfähigkeit der Maschine hin zu Umfang und Qualität der Daten.
Zunächst die Fakten dieses Vorhabens:
- Kawasaki Heavy Industries, FANUC und Yaskawa Electric bauen gemeinsam Datensätze für Embodied AI in der Fertigung auf; das Projekt wurde in das von Japans Wirtschaftsministerium METI und der NEDO getragene Förderprogramm für generative KI-Entwicklung „GENIAC“ aufgenommen;
- die drei Unternehmen entwickeln die Grundlage eines „VTLA-Modells“, das Vision, Tastsinn, Sprache und Aktion integriert verarbeitet; im ersten Jahr werden an den Fertigungsstandorten 5.000 Stunden an Bild-, Taktil- und Bewegungsdaten erhoben;
- der Projektzeitraum läuft von August 2026 bis Juli 2027, NEDO stellt bis zu 2 Mrd. JPY bereit; beteiligt sind außerdem die Universität Osaka, das Taktilsensor-Start-up FingerVision und das KI-Infrastrukturunternehmen ABEJA;
- vergemeinschaftet wird nur die „Spezifikation der Daten und die Erhebungsmethode“; die eigenen Felddaten, die Steuerungstechnik und die Hardware bleiben in den Händen jedes einzelnen Unternehmens.
Rivalen am selben Tisch
Der Plan sieht vor, dass das Projekt von August 2026 bis Juli 2027 läuft, also ein Jahr. Der Begriff Embodied AI ist in der Branche inzwischen wohlbekannt; gemeint ist KI, die in der physischen Welt handgreiflich wird – die nicht auf einem Bildschirm Text und Bilder erzeugt, sondern Arme und Hände von Robotern antreibt, damit diese greifen, montieren, transportieren und die Arbeit tatsächlich zu Ende bringen. Klingt wie ein bloß anderer Ausgabekanal, ist in Wahrheit aber ein vollkommen anderer Technologiepfad.
Auch die Rollenverteilung im Projekt ist klar: Die drei Roboterhersteller vergemeinschaften die Spezifikation der Daten und die Erhebungsplattform; die Universität Osaka agiert als Projektträger; das von ihr beauftragte ABEJA verantwortet den Ausbau der Basistechnologien; das Thema Taktilsensorik übernimmt das Start-up FingerVision. Wettbewerber, eine Universität und Start-ups finden sich für einen gemeinsamen Datensatz an einem Tisch ein – schon diese Konstellation allein zeigt, wie viel Gewicht die Sache hat.
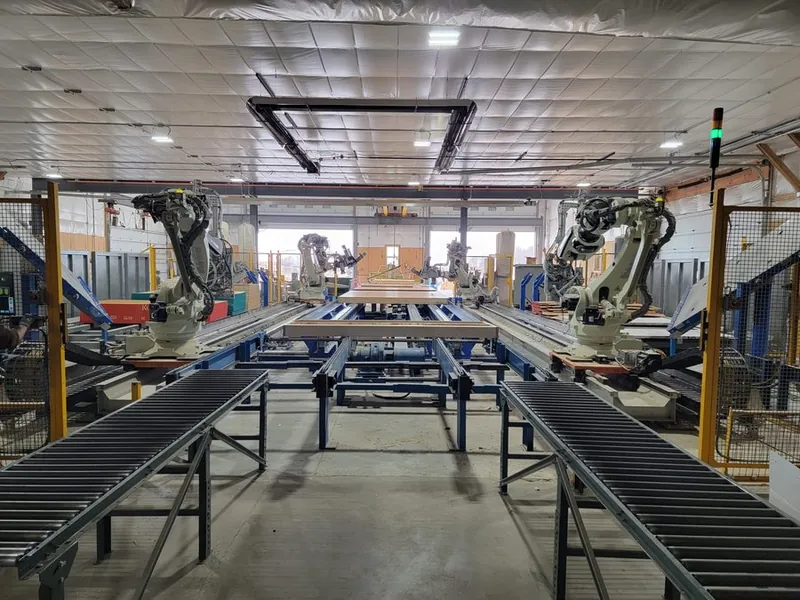
Das Zünglein an der Waage wandert vom Maschinenkörper zu den Daten
Lange Zeit war der Wettbewerb bei Industrierobotern schlicht ein Hardware-Wettbewerb. Positioniergenauigkeit, Traglast, Geschwindigkeit, Dauerhaltbarkeit – ein Datenblatt genügte im Grunde, um den Rang zu bestimmen. Genau dieses mechanische Handwerk haben japanische Hersteller über Jahrzehnte aufgebaut, und mit ihm stehen sie seit Langem in der Spitze der weltweiten Industrieroboterbranche.
Embodied AI prüft eine andere Fähigkeit. Der Mensch sagt nur „bring mir das da“ – und der Roboter muss die Lage selbst einschätzen und die Aufgabe ausführen, selbst wenn er dieses Bauteil nie zuvor gesehen hat. Solche generalisierten Handgriffe sind mit präziser Hardware allein nicht zu schaffen; sie verlangen KI, die mit gewaltigen Mengen an Prozessdaten gefüttert wurde. Auch hier gilt die Erfahrungsregel der großen Sprachmodelle: Umfang und Vielfalt der Trainingsdaten bestimmen in hohem Maß die Obergrenze des Modells.
Die Schwierigkeit: Diese Daten lagen bislang bei jedem Hersteller isoliert. Aufzeichnungsformat, was gemessen wird und wie – jede Firma handhabte es anders; die Daten von Hersteller A ließen sich nicht ohne Weiteres zum Training der Modelle von Hersteller B verwenden. Ist das Format einmal vereinheitlicht, lassen sich Daten verschiedener Unternehmen und Prozessschritte wechselseitig nutzen, der Datenpool zum Füttern der Modelle wächst schlagartig, und das Entwicklungstempo zieht an. Die Vergemeinschaftung ist genau jenes Fundament, das diese Wechsennutzung überhaupt erst trägt.
Noch deutlicher gesagt: Ein einzelner Hersteller kommt allein nicht auf hinreichend vielfältige Felddaten. Wer nur wenige Branchen und wenige Prozessarten bedient, kommt schneller voran, wenn er die Daten der Konkurrenten im gemeinsamen Format zusammenführt, statt sie jeweils für sich zu horten. Dass die Rivalen ausgerechnet jetzt kooperieren, liegt im Kern daran, dass der Gegenstand des Wettbewerbs ein anderer geworden ist.
Was VTLA vorhat: das „Beibringen“ durch „Lernen“ ersetzen
Herzstück der Entwicklung ist ein Modell namens VTLA – Vision, Tactile, Language, Action: Sehen, Tasten, Sprache und Bewegung werden integriert verarbeitet. Angestrebt ist folgende Szene: Der Roboter versteht die mündliche Anweisung eines Menschen, erkennt das Objekt über die Kamera und führt die Bewegung aus, wobei er dank des Tastempfindens an den Fingerspitzen die Krafteinwirkung fortlaufend anpasst – der gesamte Ablauf wird von einem einzigen Modell abgedeckt.
Das Besondere daran ist der Tastsinn. Klassische Industrieroboter agieren im Wesentlichen auf Basis von Bild und Positionsdaten; bei feinen Handgriffen aber – einen weichen Bauteil greifen, einen Stift in ein leicht versetztes Loch einfügen – führt kein Weg daran vorbei, Rutschen zu spüren und Anpressdruck zu dosieren. Genau diese Schwachstelle soll die Technologie von FingerVision schließen.
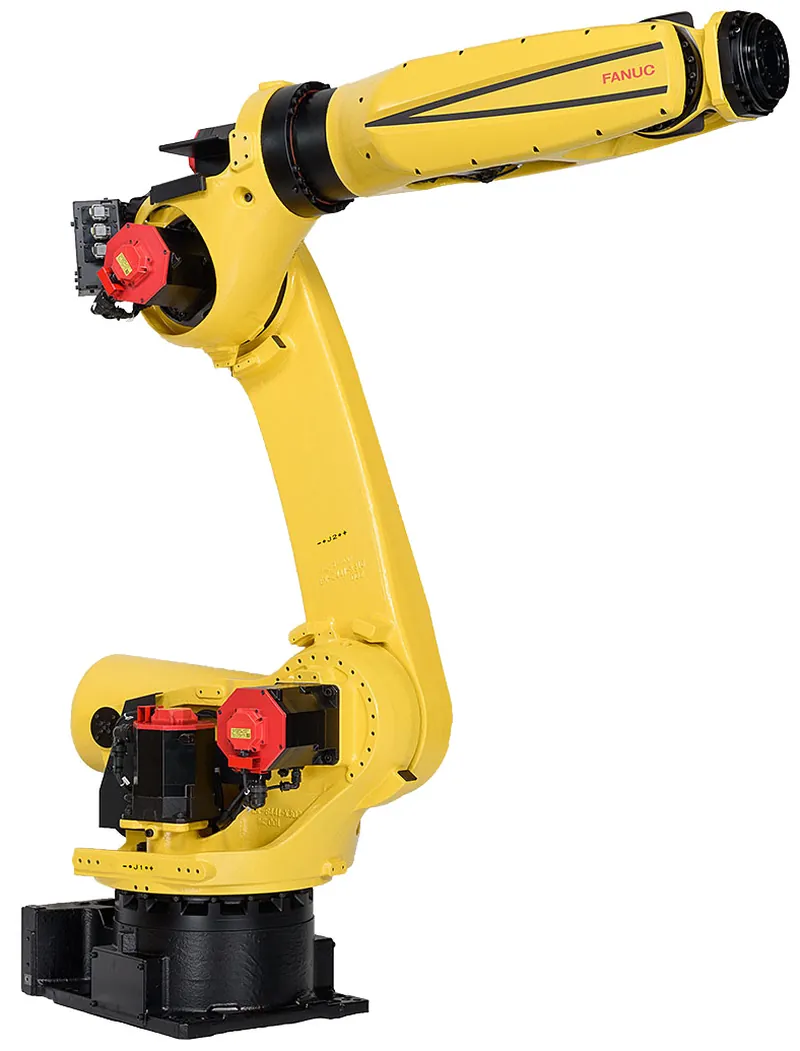
Noch bedenkenswerter ist, was das für das Teaching bedeutet. Heute hängt die Fertigung flächendeckend am „Teachen“ – jede Bewegung wird dem Roboter manuell beigebracht, und bei jedem neuen Werkstück müssen Ingenieure Koordinaten und Abläufe erneut eingeben. Dieser Arbeitsschritt ist für Fabriken mit vielen Varianten und kleinen Losgrößen die Mauer, an der jede weitere Automatisierung hakt, und zugleich der personalintensivste Flaschenhals auf Linien mit Personalmangel. Wird VTLA praxistauglich, wandelt sich die Art, wie Roboter ihre Arbeit erlernen, vom Menschen, der beibringt, zur KI, die selbst aus Daten lernt – und selbst einer erstmals gestellten Aufgabe kann der Roboter dann einigermaßen gewachsen sein. Die Grundvoraussetzung von Automatisierung könnte sich damit vom „Beibringen“ ins „Lernen“ verkehren.
Geteilt wird die Spezifikation, umkämpft wird die Definitionsmacht
Der Kern der Dreier-Allianz verbirgt sich in der Grenze zwischen dem, was geteilt wird, und dem, was nicht geteilt wird. Vergemeinschaftet werden nur Spezifikation und Erhebungsmethode der Daten – also das Regelwerk, wie aufgezeichnet und gespeichert wird. In den Händen der einzelnen Unternehmen bleiben die Felddaten aus den eigenen Werken, die Steuerungstechnik und die Hardware der Roboter sowie am Ende Produkte und Dienstleistungen. Die Regeln der untersten Ebene legt man zusammen; der Wettkampf spielt sich eine Ebene darüber ab.
Damit ist der eigentliche Streitpunkt benannt: die Definitionsmacht. Wem die im gemeinsamen Format erhobenen Daten gehören, wer sie zum Training nutzen darf, wer die Details des Standards festlegt – wer diese Hebel in der Hand hält, sichert sich in der Grundschicht von Embodied AI den Vorsprung. Eine Norm zu setzen war noch nie etwas anderes als zugleich ein Ringen um das letzte Wort bei den Einzelregeln.
Den Blick noch weiter gefasst: Dieser Schritt ist mit dem globalen Ringen um Daten verwoben. NVIDIA baut seine Position bei Embodied AI über Rechenplattformen und Simulationsumgebungen für Forschung und Entwicklung aus; die drei japanischen Hersteller führen darüber hinaus mit Fujitsu und NVIDIA Geschäftssondierungen zur gesellschaftlichen Implementierung und werden bei Rechenleistung und anderen Bausteinen auf ausländische Technik setzen. Bei der Frage des „felddatenorientierten Datenstandards“ aber wollen sie einen japanischen Datenunterbau selbst in der Hand halten – ein Stück Plattform darf ausgeliehen werden, die Datenhoheit nicht abgegeben. Genau in diesem Sinne ist diese Allianz zu lesen.
Systemintegratoren und Komponentenlieferanten müssen sich neu positionieren
Sobald universelle Datensätze und Grundmodelle Gestalt annehmen, wird die Wirkung über die Roboterhersteller hinausreichen.
Am deutlichsten verschiebt sich die Position der Systemintegratoren. Roboter in die Fertigung einzubinden und sie per Teaching zum Laufen zu bringen, war stets ihr geschäftliches Fundament. Je mehr das „Lernen“ das „Beibringen“ verdrängt, desto weniger Arbeit bleibt am manuellen Teach-Vorgang Stück für Stück; der Schwerpunkt wandert zu datenzentrierten Dienstleistungen – der Fabrik dabei helfen, passgenaue Felddaten zu erheben, und Modelle so justieren, dass sie zu einem konkreten Prozessschritt passen. Vom Installateur der Anlage zum Begleiter der Daten: Diese Rollenumschreibung muss nicht langsam vonstattengehen.
Für Komponenten- und Sensorhersteller ist es dagegen eine Chance. Wenn VTLA den Tastsinn derart nach oben holt, dürfte die Nachfrage nach Kraftsensoren, Taktilsensoren und den präzisen Mechanikbauteilen dahinter steigen – genau dies trifft die Stärken japanischer Zulieferer. Allerdings kann sich auch der Punkt, an dem Wert entsteht, verschieben: vom „Verkauf eines Sensors“ zur Frage, „wie sich die Daten dieses Sensors an die Plattform anbinden lassen“.
Noch ein Hinweis für Kollegen aus der chinesischen Branche: Ob sich dieser Datenstandard entlang der asiatischen Fertigungslieferketten nach außen ausbreitet, ist eine Variable, die sich das kommende eine bis zwei Jahre kontinuierlich zu beobachten lohnt.
Worauf künftig zu achten ist: drei Fragezeichen
Die Nutzungsrechte an den Daten. Wem die Daten nach der Vergemeinschaftung gehören, in welchem Umfang jedes Haus sie nutzen darf und wie die Entscheidungsbefugnis über die Standardinhalte zwischen den dreien verteilt ist – bleibt dies dauerhaft vage, lässt sich die Losung der Vergemeinschaftung zwar weiter ausrufen, sie wird jedoch nicht zwangsläufig zu einem echten Standard heranwachsen. Die Betriebsregeln, die das Projekt nachträglich veröffentlicht, sind das erste Beurteilungskriterium.
Die Datenmenge. Ob 5.000 Stunden im ersten Jahr genügen, um ein universelles Modell zu trainieren, ist von außen schwer zu beurteilen. Gemessen an der Textmenge, die große Sprachmodelle verschlucken, sind 5.000 Stunden eher ein Ausgangspunkt; andererseits ist der Informationsgehalt pro Stunde bei echten Prozessdaten hoch, ein blinder Stundenvergleich hinkt also. Über die Qualität des Modells entscheidet am Ende, wie viel ab dem zweiten Jahr noch hinzukommt.
Ob der japanische Standard hinausgelangt. Werden die japanischen Hersteller, die mit Hardware die Welt erobert haben, auf dem neuen Schlachtfeld „Daten“ die Oberhand gewinnen? Dieses auf ein Jahr angelegte Projekt ist der erste Lackmustest.
Für Dienstleister wie uns, die täglich mit den Anlagen dieser drei Häuser zu tun haben, hat die Sache noch eine praktische Dimension: Der „Akzent“ der Maschinen auf den Produktionslinien könnte sich ändern. Zwanzig Jahre lang waren Teaching, Parameter und Fehlersuche das Kernhandwerk der Reparatur- und Inbetriebnahmespezialisten; künftig steigen die Ingenieure im Wert, die Felddaten verstehen und die KI „füttern“ können. Die Maschinen bleiben dieselben – die Spielregeln wechseln die Spur. Verwandte Leistungen: Wartung und Instandhaltung von Importmarken, Markenabdeckung und Modellunterlagen.
Weiterlesen
- FANUC-Alarmcodes schnell nachschlagen
- Verkauf gebrauchter Roboter
- Installationsbasis chinesischer Marken und ihr Instandhaltungsökosystem



















