
En el mundo de los robots industriales, Kawasaki Heavy Industries, FANUC y Yaskawa Electric son esos rivales que se cruzan a cada paso. Que sus comerciales entren a por el mismo pedido en la misma fábrica de automóviles o en la misma planta de electrónica de consumo es, desde hace años, su rutina más normal. Y, sin embargo, en julio de 2026 las tres anunciaron que harían algo juntas, y lo que se disputan en alianza no son productos ni componentes, sino datos.
El proyecto quiere sentar los cimientos de la inteligencia encarnada en la fábrica: en su primer año prevé capturar 5000 horas de datos operativos directamente de las líneas, con el respaldo del sistema del Ministerio japonés de Economía, Comercio e Industria y una subvención máxima de NEDO de 2000 millones de JPY (unos 100 millones de CNY). El dinero no es para asombrarse; la jugada sí es poco corriente: la dirección que insinúa es que el eje de la competencia en robótica industrial se está moviendo del rendimiento del robot hacia el volumen y la calidad de los datos.
Los hechos del asunto, primero:
- Kawasaki Heavy Industries, FANUC y Yaskawa Electric se alían para construir los conjuntos de datos de la inteligencia encarnada en los entornos de fabricación; el proyecto ya ha sido seleccionado dentro de GENIAC, el programa de apoyo al desarrollo de IA generativa que impulsan el Ministerio japonés de Economía, Comercio e Industria y NEDO;
- las tres desarrollarán la base de un «modelo VTLA» que procesa de forma integrada visión, tacto, lenguaje y acción, y capturarán en el primer año 5000 horas de datos de imagen, táctiles y de movimiento en escenarios reales;
- el proyecto abarca de agosto de 2026 a julio de 2027, con una subvención máxima de NEDO de 2000 millones de JPY; participan también la Universidad de Osaka, la startup de sensores táctiles FingerVision y la empresa de infraestructura de IA ABEJA;
- lo que las tres ponen en común es únicamente «la especificación de los datos y el método de captura»; los datos de campo propios, la tecnología de control y el hardware se quedan en manos de cada una.
Rivales sentados a la misma mesa
Según lo previsto, el proyecto correrá de agosto de 2026 a julio de 2027, un año entero. «Inteligencia encarnada» ya no es un término novedoso en el sector: designa a la IA que actúa en el mundo físico; no genera texto e imágenes en una pantalla, sino que gobierna los brazos y las manos de un robot para agarrar, montar y transportar, hasta dejar el trabajo terminado de verdad. Suena a un simple cambio de destino de la salida; en la práctica es una trayectoria técnica completamente distinta.
El reparto de papeles también está claro. Los tres fabricantes de robots se encargan de poner en común la especificación de los datos y la plataforma de captura; la Universidad de Osaka ejerce como entidad central del proyecto; ABEJA, por encargo de la universidad, se ocupa de elevar las tecnologías de base; y el sensado táctil se confía a la startup FingerVision. Competidores, una universidad y startups reunidos a la misma mesa por un mismo conjunto de datos: esa combinación, por sí sola, marca la importancia del asunto.
La jugada decisiva se muda del robot a los datos
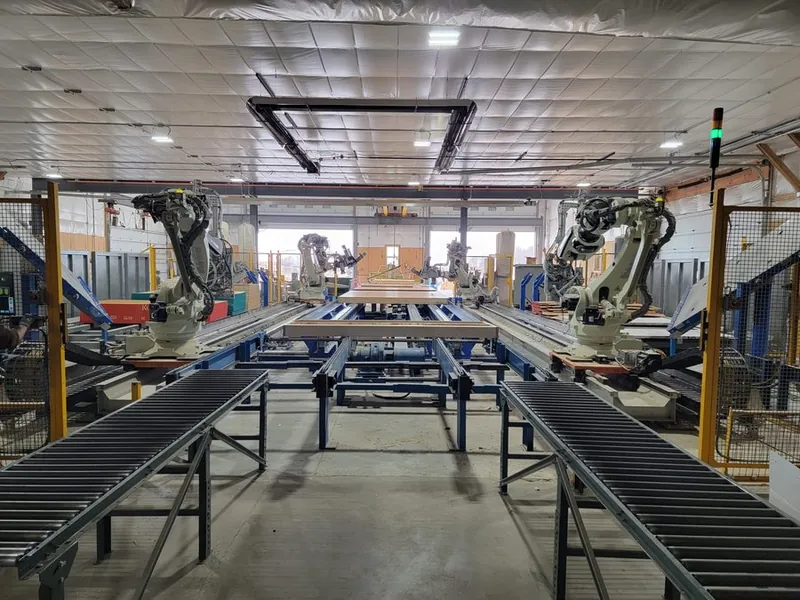
Durante mucho tiempo, competir en robótica industrial fue competir en hardware. Precisión de posicionamiento, carga útil, velocidad, durabilidad: una hoja de especificaciones bastaba, en general, para ordenar el tablero. Esa maestría mecánica es justo la que los fabricantes japoneses forjaron durante décadas, y gracias a ella han ocupado de forma sostenida la primera fila de la robótica industrial mundial.
La inteligencia encarnada examina otra capacidad. Basta que una persona diga «tráeme aquello» para que el robot deba leer la situación por sí mismo y ejecutar la tarea, aunque jamás haya visto esa pieza. Esa acción generalizable no se logra con hardware de precisión por sí solo: exige una IA alimentada con un océano de datos operativos. La regla empírica de los grandes modelos de lenguaje sigue valiendo aquí: la escala y la diversidad de los datos de entrenamiento determinan en gran medida el techo del modelo.
El problema es que esos datos han vivido hasta ahora fragmentados, cada empresa en la suya. Formato de registro, qué medir, cómo medirlo: cada casa lo hacía a su manera, y lo capturado por una no servía tal cual para entrenar los modelos de otra. En cuanto el formato se unifica, los datos de empresas y procesos distintos empiezan a poder usarse unos con otros, el acervo con que alimentar los modelos crece de golpe y la velocidad de desarrollo sube en cascada. La puesta en común es exactamente el cimiento que hace posible ese aprovechamiento mutuo.
Dicho con más llaneza: una empresa sola no reúne datos de campo suficientemente diversos. Con unos pocos sectores y unos pocos tipos de procesos en cartera, incorporar los datos de los rivales bajo un mismo formato es muchísimo más rápido que guardarlos cada uno bajo siete llaves. Si los rivales se aliaron justo ahora es, en el fondo, porque ha cambiado aquello por lo que compiten.
Lo que VTLA persigue: cambiar «enseñar» por «aprender»
El corazón del desarrollo es un modelo llamado VTLA —Vision, Tactile, Language, Action—, que procesa de manera integrada visión, tacto, lenguaje y movimiento. El escenario al que aspira: entender una instrucción hablada, examinar el objeto con las cámaras y, fiándose del tacto en las puntas de los dedos, ir ajustando la fuerza mientras completa la acción; un solo modelo cubre todo el circuito.
Lo más singular es el tacto. Los robots industriales tradicionales se mueven sobre todo con información visual y de posición, pero en labores finas —sujetar una pieza blanda, insertar un pasador en un agujero ligeramente desviado— no hay forma de esquivar la percepción del deslizamiento ni el dosificado de la fuerza de apriete. La tecnología de FingerVision llega precisamente a tapar ese hueco.
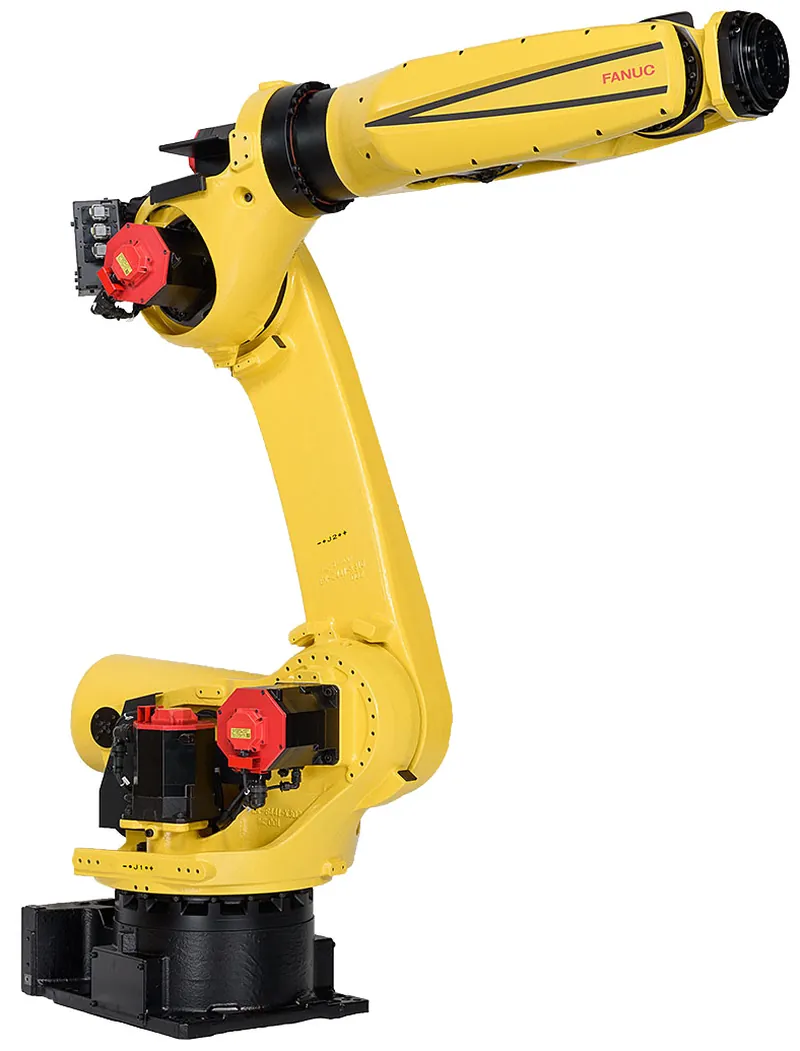
Más digno de reflexión aún es su sustitución de la enseñanza manual. Hoy la planta depende por lo general del «teach-in»: enseñar al robot los movimientos de uno en uno, a mano, de modo que cada cambio de pieza obliga al ingeniero a reintroducir coordenadas y pasos. Ese trámite es el muro inevitable de las fábricas de gran variedad y lote pequeño que avanzan hacia la automatización, y el eslabón que más personas consume en las líneas con la plantilla justa. Si VTLA llega a madurar, la manera de aprender el oficio pasará de «enseñada por el hombre» a «aprendida por la propia IA a partir de datos», y hasta un trabajo visto por primera vez podrá salirle de forma aproximada. El presupuesto mismo de la automatización podría voltearse: de «enseñar» a «aprender».
Lo que se comparte es la especificación; lo que se disputa, el poder de decisión
La esencia de la alianza se esconde en la frontera entre lo compartido y lo retenido. Lo que se pone en común son solo la especificación de los datos y el método de captura, es decir, las reglas de cómo registrar y almacenar. Lo que cada una conserva: los datos de campo de sus fábricas, la tecnología de control de sus robots y el hardware, además de los productos y servicios finales. Las reglas de base se ponen sobre la mesa común; el pulso se libra por encima de ellas.
De ahí sale el verdadero punto de fricción: el poder de decisión. De quién son los datos capturados en formato común, quién puede usarlos para entrenar, quién tiene la última palabra sobre el detalle de la norma: quien agarre esas riendas habrá tomado la delantera en la capa de base de la inteligencia encarnada. Fijar un estándar ha sido siempre, al mismo tiempo, una pugna por quién dicta sus términos.
Con una mirada más ancha, el movimiento enlaza con la disputa global por los datos. NVIDIA amplía su posición en la inteligencia encarnada a través de plataformas de cálculo para I+D y entornos de simulación; estos tres fabricantes japoneses, por otra parte, mantienen conversaciones de negocio con Fujitsu y NVIDIA sobre su despliegue en la sociedad, y en eslabones como la capacidad de cómputo se apoyarán en tecnología de fuera. Pero en lo que toca al «estándar de datos orientado al terreno», quieren sujetar ellos mismos una base de datos japonesa: la plataforma puede tomarse prestada en parte; el liderazgo sobre los datos no se entrega. La alianza debe leerse en ese sentido.
Integradores y proveedores de componentes: les toca mover casilla
Cuando los conjuntos de datos de propósito general y los modelos de fundación tomen forma, el impacto desbordará el perímetro de los fabricantes de robots.
El desplazamiento más visible será el de los integradores de sistemas. Instalar robots en la planta y ponerlos a trabajar mediante teach-in ha sido siempre su sustento. A medida que «aprender» vaya relevando a «enseñar», el trabajo de programación movimiento a movimiento disminuirá, y el centro de gravedad pasará a los servicios articulados en torno a los datos: ayudar a la fábrica a capturar los datos que encajan con su realidad y afinar el modelo hasta ajustarlo a un proceso concreto. De instaladores de equipos a acompañantes de los datos: esa reescritura del papel no tiene por qué ser lenta.
Para los fabricantes de componentes y sensores, en cambio, se abre una oportunidad. Al elevar el tacto a un puesto tan alto, VTLA puede disparar la demanda de sensores de fuerza, sensores táctiles y la mecánica de precisión que los sostiene, un terreno que cae de lleno en el punto fuerte del proveedor japonés de componentes. Eso sí, también puede moverse el lugar donde aterriza el valor: de «vender un sensor» a «cómo se enchufa a la plataforma el dato que ese sensor captura».
Y hay un detalle que los colegas del sector en China harían bien en vigilar: que este estándar de datos se extienda o no a lo largo de la cadena de suministro manufacturera asiática es una variable que merece observación continua durante el próximo año o dos.
Qué vigilar a partir de ahora: tres interrogantes
El derecho de uso de los datos. A quién pertenecerán los datos tras la puesta en común, hasta dónde podrá usarlos cada empresa y cómo se repartirá entre las tres la potestad de decidir el contenido de la norma: si todo esto sigue en la niebla, la consigna de la estandarización puede corearse indefinidamente sin llegar a cuajar en un estándar de verdad. Las reglas de gestión que el proyecto publique más adelante serán el primer criterio de juicio.
El volumen de datos. Si 5000 horas en el primer año bastan para entrenar un modelo de propósito general, desde fuera es difícil evaluarlo. Frente al volumen de texto que devoran los grandes modelos de lenguaje, 5000 horas parecen más bien un punto de partida; aunque cada hora de datos de operaciones reales concentra muchísima información, así que tampoco vale comparar por horas en bruto. Lo que de verdad decidirá la calidad del modelo es cuánto se pueda añadir a partir del segundo año.
Si el estándar japonés logra salir al mundo. Los fabricantes japoneses que dominaron el planeta con el hardware, ¿serán capaces de asir el mando en «datos», el nuevo campo de batalla? Este proyecto de un año es la primera piedra de toque.
Para un proveedor de servicios como nosotros, que convive a diario con los equipos de estas tres marcas, el asunto tiene además un significado muy práctico: el «acento» de las máquinas en las líneas puede empezar a cambiar. Durante los últimos veinte años, el oficio nuclear del ingeniero de mantenimiento y puesta a punto ha sido el teach-in, los parámetros y el diagnóstico de averías; a partir de ahora, los ingenieros que entiendan los datos de campo y sepan «dar de comer» a la IA valdrán cada vez más. Las máquinas siguen siendo las mismas; el juego está cambiando de carril. Servicios relacionados: reparación y mantenimiento de marcas importadas, cobertura de marcas y documentación de modelos.
Lecturas relacionadas
- Consulta rápida de códigos de alarma FANUC
- Venta de robots de segunda mano
- Parque instalado de marcas nacionales y ecosistema de mantenimiento



















